如果你坐高铁从广州去哈尔滨,大概率买不到一趟从家门口直到终点的直达车。你得先坐到武汉或郑州换乘,再倒车往北走。
这套方案有一个显而易见的好处:每一座高铁站,其实都不需要知道你从哪儿来到哪儿去。 换乘的调度员其实只管一件事:看一眼你手里的下一程车票,告诉你去 3 号站台,上 G1234 次列车。至于你到了沈阳是转普速列车还是出站打车,当前的车站根本不关心,调度员也不需要记住所有车次和方向。
互联网的数据传输几乎完全复制了这种“分段接力”。
前三章里,我们知道了局域网内部的杂事:
- IP 地址是网络层的门牌号;
- MAC 地址是二层网卡的物理身份码;
- DHCP 给你发放IP地址;
- ARP 帮你找到目标 IP 对应的 MAC;
- DNS 把人能读懂的域名换成机器认得的 IP。
在之前的文章,你的电脑向 DNS 服务器查询到了百度的 IP,并且意识到这个百度的 IP 根本不在我家的局域网里,因此必须把数据包交给默认网关(也就是家用路由器)。
但当数据包“啪”一下甩到路由器脸上之后呢?
路由器又凭什么知道往哪送?它手里拿着几亿个互联网 IP 的表吗?
还有要知道世界上的IPv4地址总共有约42.95亿个,而中国只有约3.4亿个,不可能每个人每个设备都有一个ip地址。
所以诡异的事情就发生了,你爸在刷短视频,你在玩游戏,你妈在看直播,家里这么多个设备共用着宽带运营商施舍的那一个 IP,回来的数据包怎么就那么精准,游戏包进了你的电脑,短视频流进了你爸的手机,丝毫没串台?
这篇我们就把数据包跨出家门后的底层运转全盘拆开。
核心有两个内容:路由和 NAT。
4.1 “路由”和“转发”不是一回事
有些人经常说“路由器在路由数据”,但如果你去扒网络协议栈的源码,或者看网络芯片的架构,会发现它做的是截然不同的事。
计算机网络在体系上被分成了两半:控制平面(Control Plane) 与 数据平面(Data Plane / Forwarding Plane)。
- 控制平面 (Control Plane) 适合慢速、算力密集、脑力活 路由协议 (OSPF / BGP / RIP)
- 数据平面 (Data Plane) 适合极速、硬件查表、体力活 入端口
1. 路由(Routing):制定路线图
这是控制平面的活。
世界各地的路由器彼此交换链路状态信息、算权值。这个过程相对缓慢且费脑筋:拓扑坏了要重算,邻居挂了也要改,算完了在内存里存了一张庞大的逻辑路由表(RIB, Routing Information Base)。
2. 转发(Forwarding):按规则执行
这是数据平面的活,只是机械的执行。
数据包带着目标 IP 进入网络接口,先直接去查转发表(FIB, Forwarding Information Base)。利用算法快速判断然后转发数据。
打个比方:
铁路总局花了三个月测算人流、轨道负荷、编制出全国列车运行图——这是路由;
车站闸机扫了一下乘客的身份证,滴的一声放行,指示屏显示“往第 4 站台走”——这是转发。
所以你在家里插上路由器就能上网,你的路由器并没有算出通往目的地的完整捷径,它只用把不是局域网内部的数据转发给它的上一层。
4.2 路由表长什么样?
既然转发靠查表,那这张表到底怎么记录路径?
如果你在 Linux 敲下 ip route 或者 Windows 敲下 route print,你会看到一张表格:
| 目的网络(Destination) | 子网掩码 / 前缀(Genmask) | 下一跳(Gateway / Next Hop) | 出接口(Interface) | 度量值(Metric) |
|---|---|---|---|---|
192.168.1.0/24 |
255.255.255.0 | 0.0.0.0(直连 on-link) | eth0 (LAN) | 0 |
10.0.0.0/8 |
255.0.0.0 | 192.168.1.254 | eth0 (LAN) | 10 |
0.0.0.0/0 |
0.0.0.0 | 192.168.1.1 | eth1 (WAN) | 100 |
每个字段的含义:
- 目的网络:匹配这一类 IP 的网段。
/24代表前 24 位固定,表示192.168.1.0 ~ 192.168.1.255这个网段的所有 IP 都可以归这一行管。 - 下一跳(Next Hop):数据包下一步该物理交接给谁。如果是“直连”,意味着这个网段就焊在当前路由器的某个网口上,走二层 ARP 就能摸到;如果写了具体 IP,就意味着必须先把包甩给那台机器替你中转。
- 出接口:包该往哪个物理网口(或逻辑接口)发射。
- 度量值(Metric):成本打分。如果有两条路都能去同一个地方,谁的 Metric 越小,走谁。
互联网扩容的经典:只记录“下一跳”
路由表的设计里藏着整个现代互联网之所以能够无限扩展的核心秘密:无状态逐跳转发(Hop-by-Hop Routing)。
一台位于上海徐汇区的边缘路由器,在转发你发给芝加哥大学服务器的请求时,它完全不知道、也不需要知道这趟旅途的第 x 站是东京还是洛杉矶。 它只需要知道一件事:把数据从自己的“x号接口”交给“下一跳”,剩下的事就由下一跳节点去发愁。
如果每台路由器都存下全网几十上百亿台设备的完整路径链,哪怕全球最大的数据中心也吃不消。下一跳机制把问题解决了:局部决策,全局收敛。
最长前缀匹配原则(Longest Prefix Match)
如果一个包的目的 IP 是 10.1.2.3,而路由表里同时存在:
- 条目 A:
10.0.0.0/8 - 条目 B:
10.1.0.0/16 - 条目 C:
0.0.0.0/0
这三个条目全都命中了这个 IP,路由器该听谁的?
规则也十分简单:谁的网络掩码长就听谁的。
/16 比 /8 和 /0 提供了更精准、更细粒度的地理范围。这就像寄快递,包裹上既写了“中国”,又写了“浙江省杭州市西湖区文三路”,快递员绝不会把它随便扔在浙江省随便一个地方,他必须按最具体的那条地址送。
因此,路由器会选择走条目 B。
默认路由:兜底
那个写成 0.0.0.0/0 的东西,叫做默认路由(Default Route),在主机上它通常被唤作“默认网关(Default Gateway)”。
/0 意味着它的掩码长度为 0,也就是前缀匹配 0 个 bit,全宇宙的所有 IP 都会无条件匹配它。
但是因为上面提到的“最长前缀匹配”原则,它的优先级垫底。
只有当查遍整个路由表,没有一个明细网段能够认领这个目的 IP 时,路由器才会叹口气,把数据丢给默认网关:“我尽力了,我不认识它,丢给你了,你见识广,你来处理吧”。
你在家里之所以能访问各种千奇百怪的公网服务器,就是靠这行 0.0.0.0/0 默默托底。
4.3 动态路由:实时修改的神器?
小型网络和家用网关的路由表都是写死的(静态路由)或者自动分配一条默认路由。但在跨越城市、跨越大洲的复杂网状拓扑里,某处的施工挖断了光缆,某处的数据中心机房断了电,拓扑结果不断在变,谁来重新修复?
这必须靠动态路由协议(Dynamic Routing Protocols)。大型路由器会通过互相连接交换信息,依靠算法算出全局路径。
从底层数学本质上划分,经典算法只有两大门派:
距离向量算法 (Distance Vector) 与链路状态算法 (Link State)
门派一:距离向量算法(Distance Vector)传话筒
距离向量的核心思想极度朴素:我只和我的邻居交流,但我把我知道的一切都告诉他。
它底层依托的是计算机科学里的 Bellman-Ford 算法。
每个路由器周期性地把自己的整张路由表复制一份,递给相邻的路由器:“兄弟,这是我去各个目的地的开销,你瞅瞅”。
邻居拿到之后,在每个开销上加上自己到该路由器的线路开销,然后对比自己原先的表:如果发现从你这里走居然更近,我就把自己的下一跳改成你。
但是
距离向量算法有个极其痛苦的先天缺陷:坏消息传得极慢,容易互相欺骗。
[节点 A] <-- 成本 1 --> [节点 B] <-- 成本 1 --> [节点 C]假设节点 C 是目的地:
- 正常时,B 到 C 成本是 1,A 到 C 成本是 2(下一跳指着 B)。
- 突然,B 到 C 之间的物理线缆被铲车挖断了。
- B 猛然发现自己到不了 C 了。
- 但在下一刻,A 把自己的旧路由表发给了 B:“老哥,我这里有条去 C 的路,成本是 2 呢!”
- B 傻了,心想:“我虽然去不了 C,但 A 能去啊!那我把下一跳改成 A,成本算作 2 + 1 = 3 吧!”
- 紧接着,B 又把新成本 3 通报给 A。A 一看:“咦,B 涨价了,那我走 B 的成本得改成 3 + 1 = 4……”
两个人就这么来回递话,2、3、4、5……一路累加,直到某个设定的上限才能识破骗局。这就是臭名昭著的 Count-to-Infinity(计数到无穷大) 故障。
为了解决,工程界发明了一堆补丁技术:
- 定义无穷大:比如 RIP 协议粗暴地规定 16 跳就算不可达,因此 RIP 根本无法用于节点超过 15 步的大网。
- 水平分割(Split Horizon):“我从你这边学来的路由信息,绝不反向再通报给你”。
- 毒性逆转(Poison Reverse):“我从你这学来的路由,我再告诉你时,故意把成本标成无穷大(16)”,明确断绝你的侥幸幻想。
即便打了这么多补丁,距离向量协议在大规模复杂网络中依然脆弱,逐渐退出了骨干舞台。
门派二:链路状态算法(Link State)
链路状态算法走的是完全相反的路线:我只把我的局部信息(我有几个邻居、线路延迟多大)打成包,但我会把这个包广播给所有人!
它的意义是:全网每个路由器最后都收到一模一样的零件清单。有了这些清单,大家在各自内存里拼出一张完全一致的全局拓扑图(拓扑数据库 LSDB)。
最后,每个路由器以自己为根节点,在本地安安静静地跑一遍图论鼻祖算法——Dijkstra 最短路径优先算法(SPF),算出一棵以自己为中心的最短路径树,直接填进路由表。效果十分好:
- 收敛奇快:哪条线断了,一条微小的链路状态更新报文(LSU)就发给全网,大家各自刷一下 Dijkstra 重新生成路径,绝无循环可能。
运用中企业网和骨干网的 OSPF(开放式最短路径优先) 和运营商钟爱的 IS-IS。
代价?当然是费 CPU 和内存。小路由器要是塞进几万个节点的 LSDB,光跑一遍 Dijkstra 就能把芯片跑冒烟。
全球互联网:BGP(边界网关协议)
如果说 OSPF 搞定的是一个公司、一个高校内部(IGP,内部网关协议),那把腾讯、阿里、中国电信、AT&T、AWS 这些各自的“王国”拼接成全球互联网的,是 BGP(Border Gateway Protocol)。
内部局域网有很多协议,但 BGP 是唯一的 EGP(外部网关协议),它不搞什么 Dijkstra算法,也不只死板地看延迟与跳数。它是一种路径向量(Path-Vector)协议。
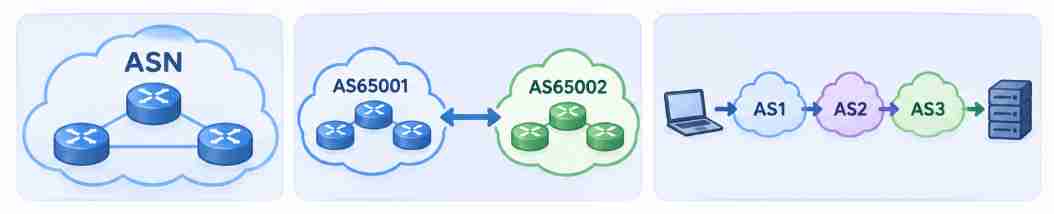
在 BGP 的世界里,每个巨头网络都是一个 AS(自治系统,Autonomous System)。
BGP 路由传过来的不是“下一跳”,而是一串国家和机构的名单:去往网段 X,途经 [AS4134(中国电信) -> AS2914(NTT) -> AS15169(Google)],像下图示例的。
更重要的是,BGP 讲政治、讲商业利益。
电信走联通的线路可能要交过路费,走自家线路不用;所以哪怕走联通延迟只有 20ms,电信也可以通过 BGP 策略强行改道走自己 80ms 的骨干网,BGP 与商业和策略相关联。
4.4 路由器转发数据包时
这个时候你可能直觉上认为:数据包从我电脑出发,一路漂洋过海到达百度,这个数据包本身就像一个封好的信封,原封不动地被搬运。
大错特错。
在网络层和数据链路层交替处,每一次经过路由器,数据包都会被改动。
我们对比一下有哪些不同:
路由器转发前:原始数据包
源 MAC:电脑网卡 MAC 地址
目的 MAC:路由器 LAN 口 MAC 地址
源 IP:192.168.1.55
目的 IP:110.242.68.3
路由器转发后:重新封装数据包
源 MAC:路由器 WAN 口 MAC 地址
目的 MAC:运营商下一跳网关 MAC 地址
源 IP:219.152.168.222(经过 NAT 转换)
目的 IP:110.242.68.3
TTL:减 1
IP 首部校验和:重新计算
看清楚其中的变化:
- IP 头部里的 TTL(Time to Live,生存时间)被减了 1。
TTL 每经过一跳就会减1,这是防止环路死循环的装置。如果一条路由配置失误出现了环路,数据包不会在两台路由器之间无限转圈把光纤占满,TTL 减到 0 时,当前路由器直接将包扔进垃圾桶,并给源主机发回一个
ICMP Time-to-Live Exceeded报文。网络排错命令traceroute就是利用这个机制,把 TTL 从 1 开始递增,把沿途所有路由器的 IP 找出来的。 - IP 校验和(Checksum)被重新计算了。 因为 TTL 变了,头部数据变了,旧校验和失效,硬件必须立即刷新。
- 二层的 MAC 地址被彻底剥掉并全部换掉 源 MAC 变成了路由器的出接口 MAC,目的 MAC 变成了下一跳路由器的 MAC。MAC 地址永远只在局域网一跳之内有效,出了就会变。
但等一下……上面的,为什么源 IP 从 192.168.1.55 变成了 219.152.168.222?
纯粹的路由只查目的 IP,根本不会改源 IP 啊?
这就要引出最重要、同时也是把现代互联网折腾得最痛苦的补丁技术——NAT。
4.5 NAT:IP 资源枯竭年代的活命手段
4.5.1 历史原罪:IPv4 真的不够分了
前面也提到过,1981 年制定 RFC 791(IPv4 标准)时,设计者给地址分配了 32 个 bit,理论上限大约 42.9 亿个。
在当年冷战科研背景下,没人能预见到日后连家里的电饭煲、智能灯泡、车载中控都要分一个 IP。
90 年代初,互联网爆发前夕,工程师们猛然惊醒了,IPv4 要枯竭了!
终极方案当然是换成 128 位的 IPv6(地址多到能给地球上的每一粒沙子分配成千上万个 IP)。但这涉及全球所有路由器、操作系统、交换机、协议栈推倒重来,进展极其缓慢。
工程师们急中生智,联手制定了两个救命的方案:
- CIDR(无类域间路由):废除死板的 A/B/C 类地址,按前缀掩码切细碎网段(RFC 1519)。
- 私有地址空间(RFC 1918)与 NAT(RFC 1631 / RFC 2663)。
RFC 1918 划出了三段在公网上“明令禁止路由”的私有保留地址:
10.0.0.0 ~ 10.255.255.255(掩码 /8,巨型企业内网,比如学校校园网)172.16.0.0 ~ 172.31.255.255(掩码 /12,中型企业内网)192.168.0.0 ~ 192.168.255.255(掩码 /16,小型家庭内网)
这三段地址全世界任何人都可以随便用,你家在用 192.168.1.1,隔壁老王家也是 192.168.1.1,五道口网吧还是 192.168.1.1。
大家关起门来自嗨没问题,但如果你把这私有地址发进公网,骨干网的路由器一查表发现是私有网段,会当场面无表情地把它直接丢弃(Drop)。
私网的数据包要想去公网,必须找人代办用合法身份——这就是 NAT(网络地址转换)。
4.5.2 NAPT(网络地址与端口转换):一人办证,全村共用
严格意义上的 NAT 分好几种:
- 静态 NAT(Static NAT):1 个内网 IP 绑死 1 个外网 IP。纯属浪费,根本不解决地址不够用的问题。
- 动态 NAT(Dynamic NAT):申请一个外网 IP 池,内网谁上线就借一个,下线归还。IP 依然是一对一,但是在不同时段可以被不同人借用。
家庭路由器使用的是 NAPT(Network Address Port Translation,网络地址端口转换,也常被称为 PAT)。
它不仅改 IP,还改了四层传输层(TCP/UDP)的端口号。
一个请求发出时
你打开手机,看百度首页:
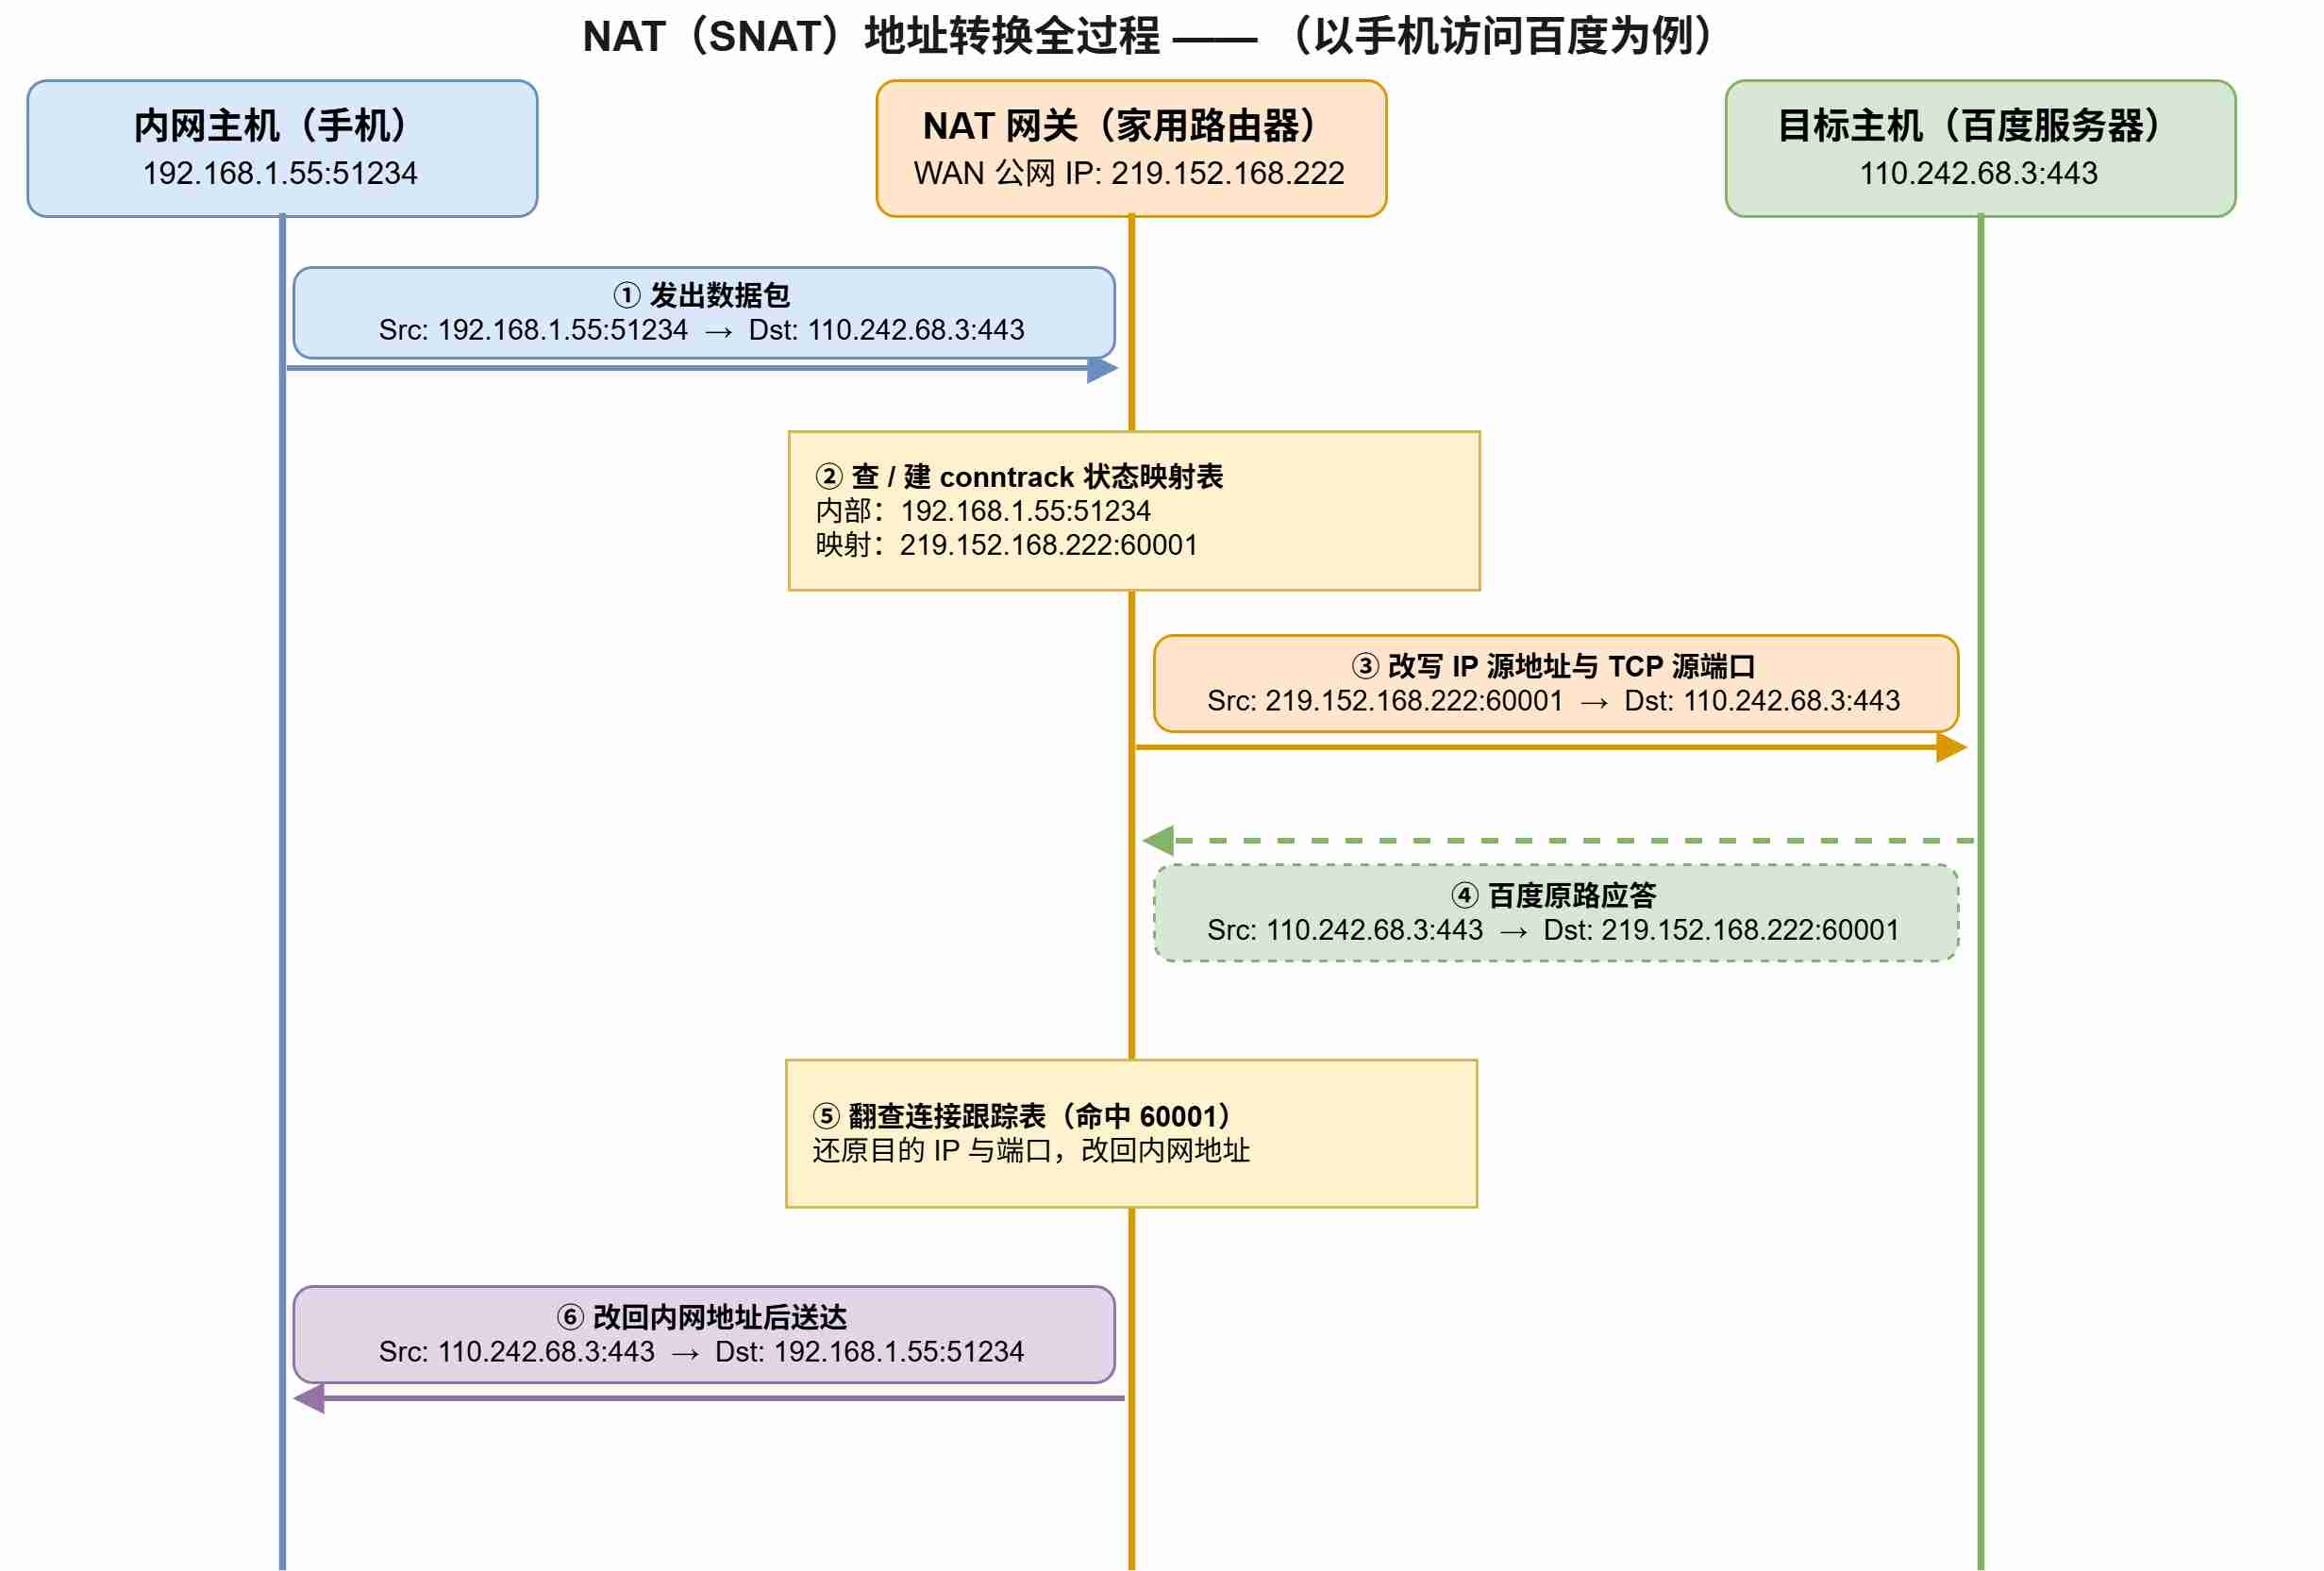
连接跟踪表(Connection Tracking Table,在 Linux 内核里由 nf_conntrack 维护):
| 协议 | 内网 IP : 端口 | 路由器的外网 IP : 端口 | 目的服务端 IP : 端口 | 状态 / 超时时间 |
|---|---|---|---|---|
| TCP | 192.168.1.55:51234 |
219.152.168.222:60001 |
110.242.68.3:443 |
ESTABLISHED |
| TCP | 192.168.1.66:51234 |
219.152.168.222:60002 |
110.242.68.3:443 |
ESTABLISHED |
注意看第二行!
哪怕你弟的电脑(192.168.1.66)和你使用了同一个本地源端口(51234)去访问百度的同一个端口,路由器也丝毫不慌。
它直接在外网口分配了不同的公网端口:你走 60001,你弟走 60002。
百度服务器完全被蒙在鼓里。在它看来,全中国就只有个 IP 为 219.152.168.222 的设备,同时开了成百上千个端口在和它疯狂通信。等响应包回来时,路由器瞄一眼外网端口是 60001 还是 60002,顺藤摸瓜,各回各家,井井有条。
这就是为什么 TCP/UDP 头部原本仅仅设计用来区分操作系统内进程的 16 位端口号(共 65535 个),在网络层被无情征用,成了临时代号”。
4.6 NAT 带来的灾难
NAT 确实把 IPv4 的阳寿硬生生续了三十年,但它在网络工程界招致了无数系统架构师的切齿痛恨。
它破坏了互联网最神圣的基石——端到端原则(End-to-End Principle)。
在理想的网络设计中,网络核心只管笨拙地搬运,两端主机拥有对等、独立的身份,彼此可以随时自由发起握手。
而 NAT 的横空出世,在端与端之间筑起了一道单向玻璃:里面的人看得到外面,外面的人根本看不到里面。
这导致了一连串令人头秃的连锁反应:
1. 外网怎么主动连内网?(端口转发 / DNAT)
如果想在家里 NAS 或工控机上搭个网站,让外网朋友来访问,默认是不可能的。
外网访问你的公网 IP 219.152.168.222:8080,路由器收到这个包,翻看连接跟踪表,发现根本没有内网设备主动发起的记录!“哪来的野包?”,直接将其拒之门外。
解决办法:在路由器后台手工配一条 端口映射(Port Forwarding,也就是 DNAT 目的地址转换):
凡是向我 WAN 口的
8080端口发送的数据包,无条件将目的 IP 改写为192.168.1.100,目的端口改写为80,但是这个权限要求挺高的,普通人几乎没办法更改,除非你有运营商内部的关系。
2. 协议 Payload 失效
有些古老协议(最经典的就是主动模式 FTP,还有 SIP 语音协议),通信双方会在应用层载荷(Payload)的文本里明文宣称:“我的 IP 是 192.168.1.55,请你在 20 端口连我”。
路由器普通 NAT 只会改外层 IP 头,不管里面装的文字。结果服务端傻呵呵地去连 192.168.1.55,直接崩溃。
为了救活这些应用,路由器又不得不硬塞进一个叫 ALG(应用层网关,Application Level Gateway) 的模块。ALG 必须深度嗅探甚至解密应用层载荷,发现里面藏了私有 IP,顺手也给改掉,这让原本纯净的网络层转发彻底沦为越权控制的屎山。
4.7 P2P 联机噩梦:NAT 的四种状态与“打洞”
对于普通冲浪(Web 浏览、刷视频),NAT 毫无破绽,因为全是客户端先往服务端发请求。 但联机游戏开黑、BT/PT 下载、视频会议通话这类的 P2P(Peer-to-Peer 点对点通信) 场景,两个玩家都躲在各自家里的 NAT 后面,谁也主动连不上谁,怎么办?
这就逼出了网络工程史上脑洞大开的操作:NAT 穿透(NAT Traversal,俗称“打洞” Hole Punching)。
能否打洞成功,全看你家路由器和运营商 NAT 模式属于哪种状态。
历史上著名的 RFC 3489 确立了四种经典分类(虽然被后续 RFC 4787/5389 细化为映射和过滤行为,但经典模型对直观理解极其透彻):
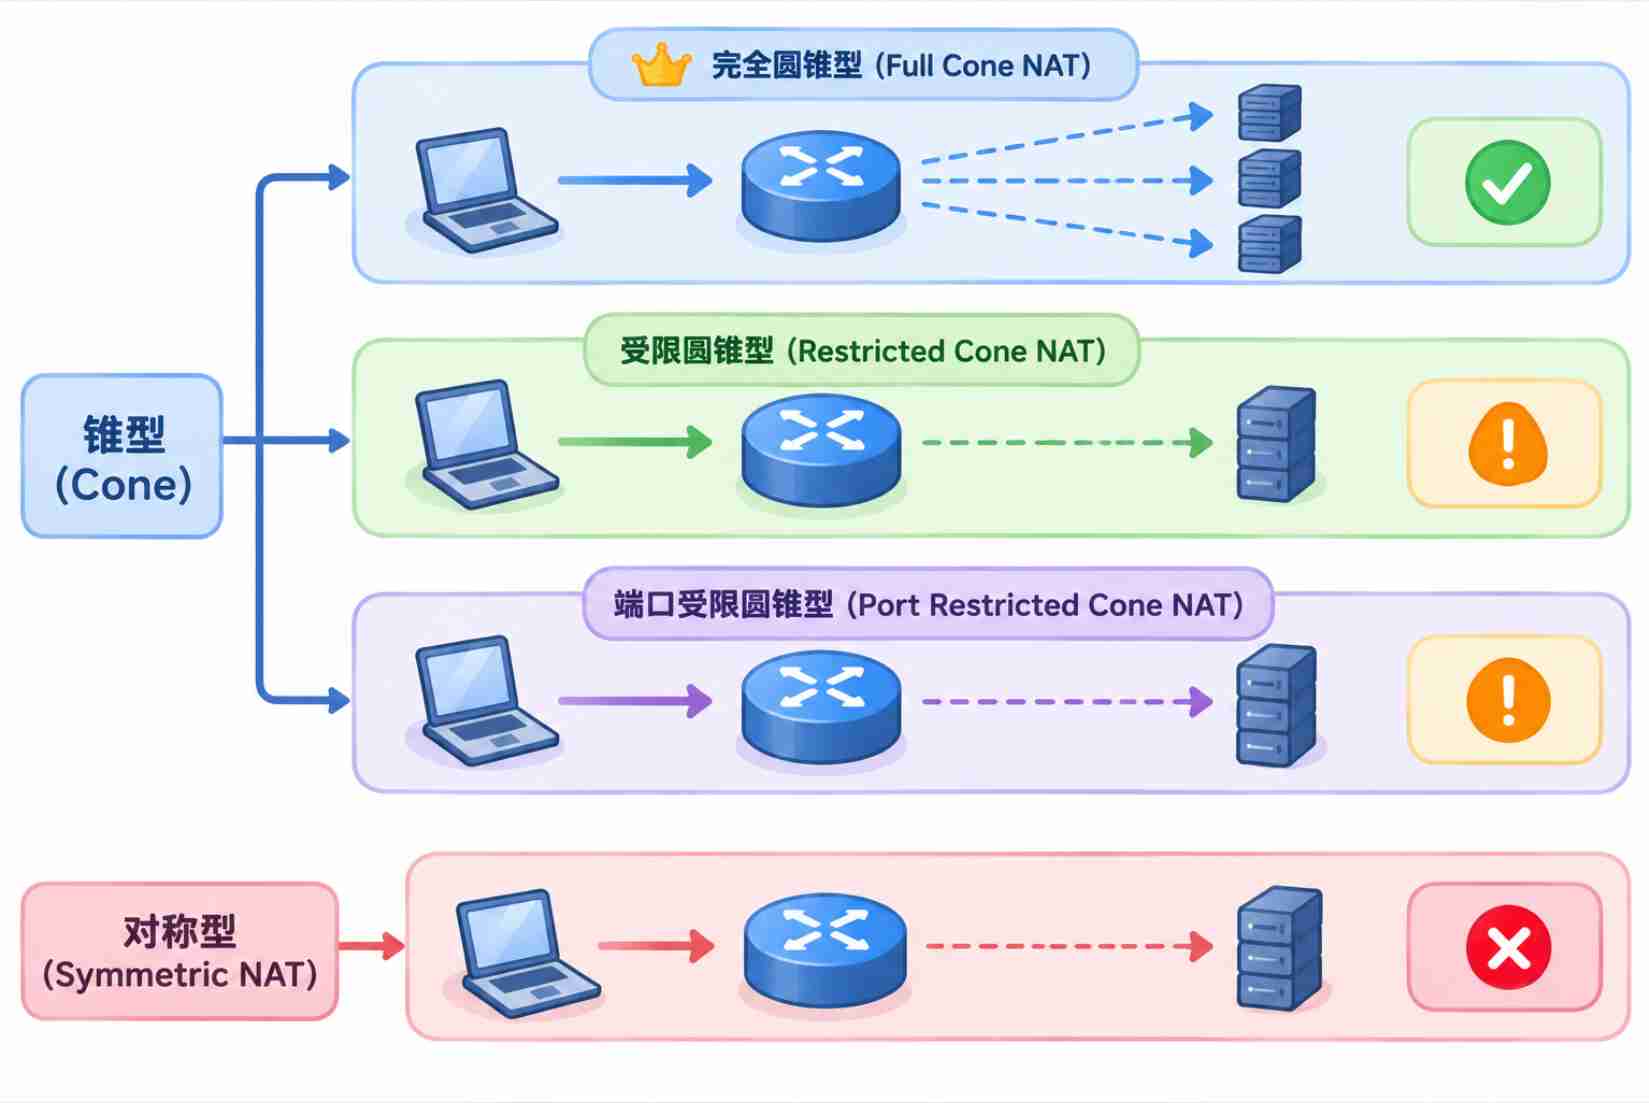
1. NAT 1:完全圆锥型(Full Cone NAT)
简直是来者不拒的代名词。
内网主机只要向任意外网地址发了一个包,路由器就会为它建一条映射 [内网IP:端口 <-> 公网IP:端口]。
从这一刻起,全世界任何其他外网机器,向这个公网 IP 和端口扔数据,路由器通通放行并转给内网主机。
- 穿透难度:极低。只要内网先往外打个招呼,洞就全开了。
2. NAT 2:受限圆锥型(Restricted Cone / Address-Restricted Cone)
认人不认端口。
内网主机曾向公网主机 A(1.1.1.1)发过数据,NAT 映射生效。
此时,只有主机 A 能往这个公网端口发数据包,外网其他 IP(如主机 B 2.2.2.2)发来的包会被丢弃。但是主机 A 用它的哪个端口发过来都行(80 端口行,5000 端口也行)。
3. NAT 3:端口受限圆锥型(Port-Restricted Cone)
最普遍的家用宽带类型。认人,也认端口。
内网主机曾向 1.1.1.1:8000 发过数据,那外网就必须同时满足 源 IP 是 1.1.1.1 且 源端口是 8000,包才能进得来。换个端口发都不行。
4. NAT 4:对称型(Symmetric NAT)
P2P 的火葬场。
前面三种统称“圆锥型”,因为无论内网主机去找百度、去打游戏还是去查天气,只要本地端口不变,路由器映射出去的公网端口都是同一个(所以像一个喇叭状的圆锥体)。
对称型太绝了:
- 内网主机访问目标 A(
1.1.1.1:80),映射为公网IP:60001; - 紧接着访问目标 B(
2.2.2.2:80),路由器强行重新分配一个全新端口公网IP:60002! - 也就是说,映射完全绑定“源四元组 + 目的四元组”。
这直接判了传统打洞技术的死刑!
因为你找第三方的打洞协助服务器(STUN)查到了自己的外网映射端口是 60001,兴高采烈把这个端口告诉了游戏联机队友;但当你掉头去连队友时,对称 NAT 立刻分配了全新的端口 60002,队友朝着 60001 猛烈开火,打了个寂寞。
打洞实操:STUN 与 TURN
游戏主机(Switch、PS5、Xbox)在网络测试界面测出的“NAT 类型”,本质上就是测上面的四级阶梯:
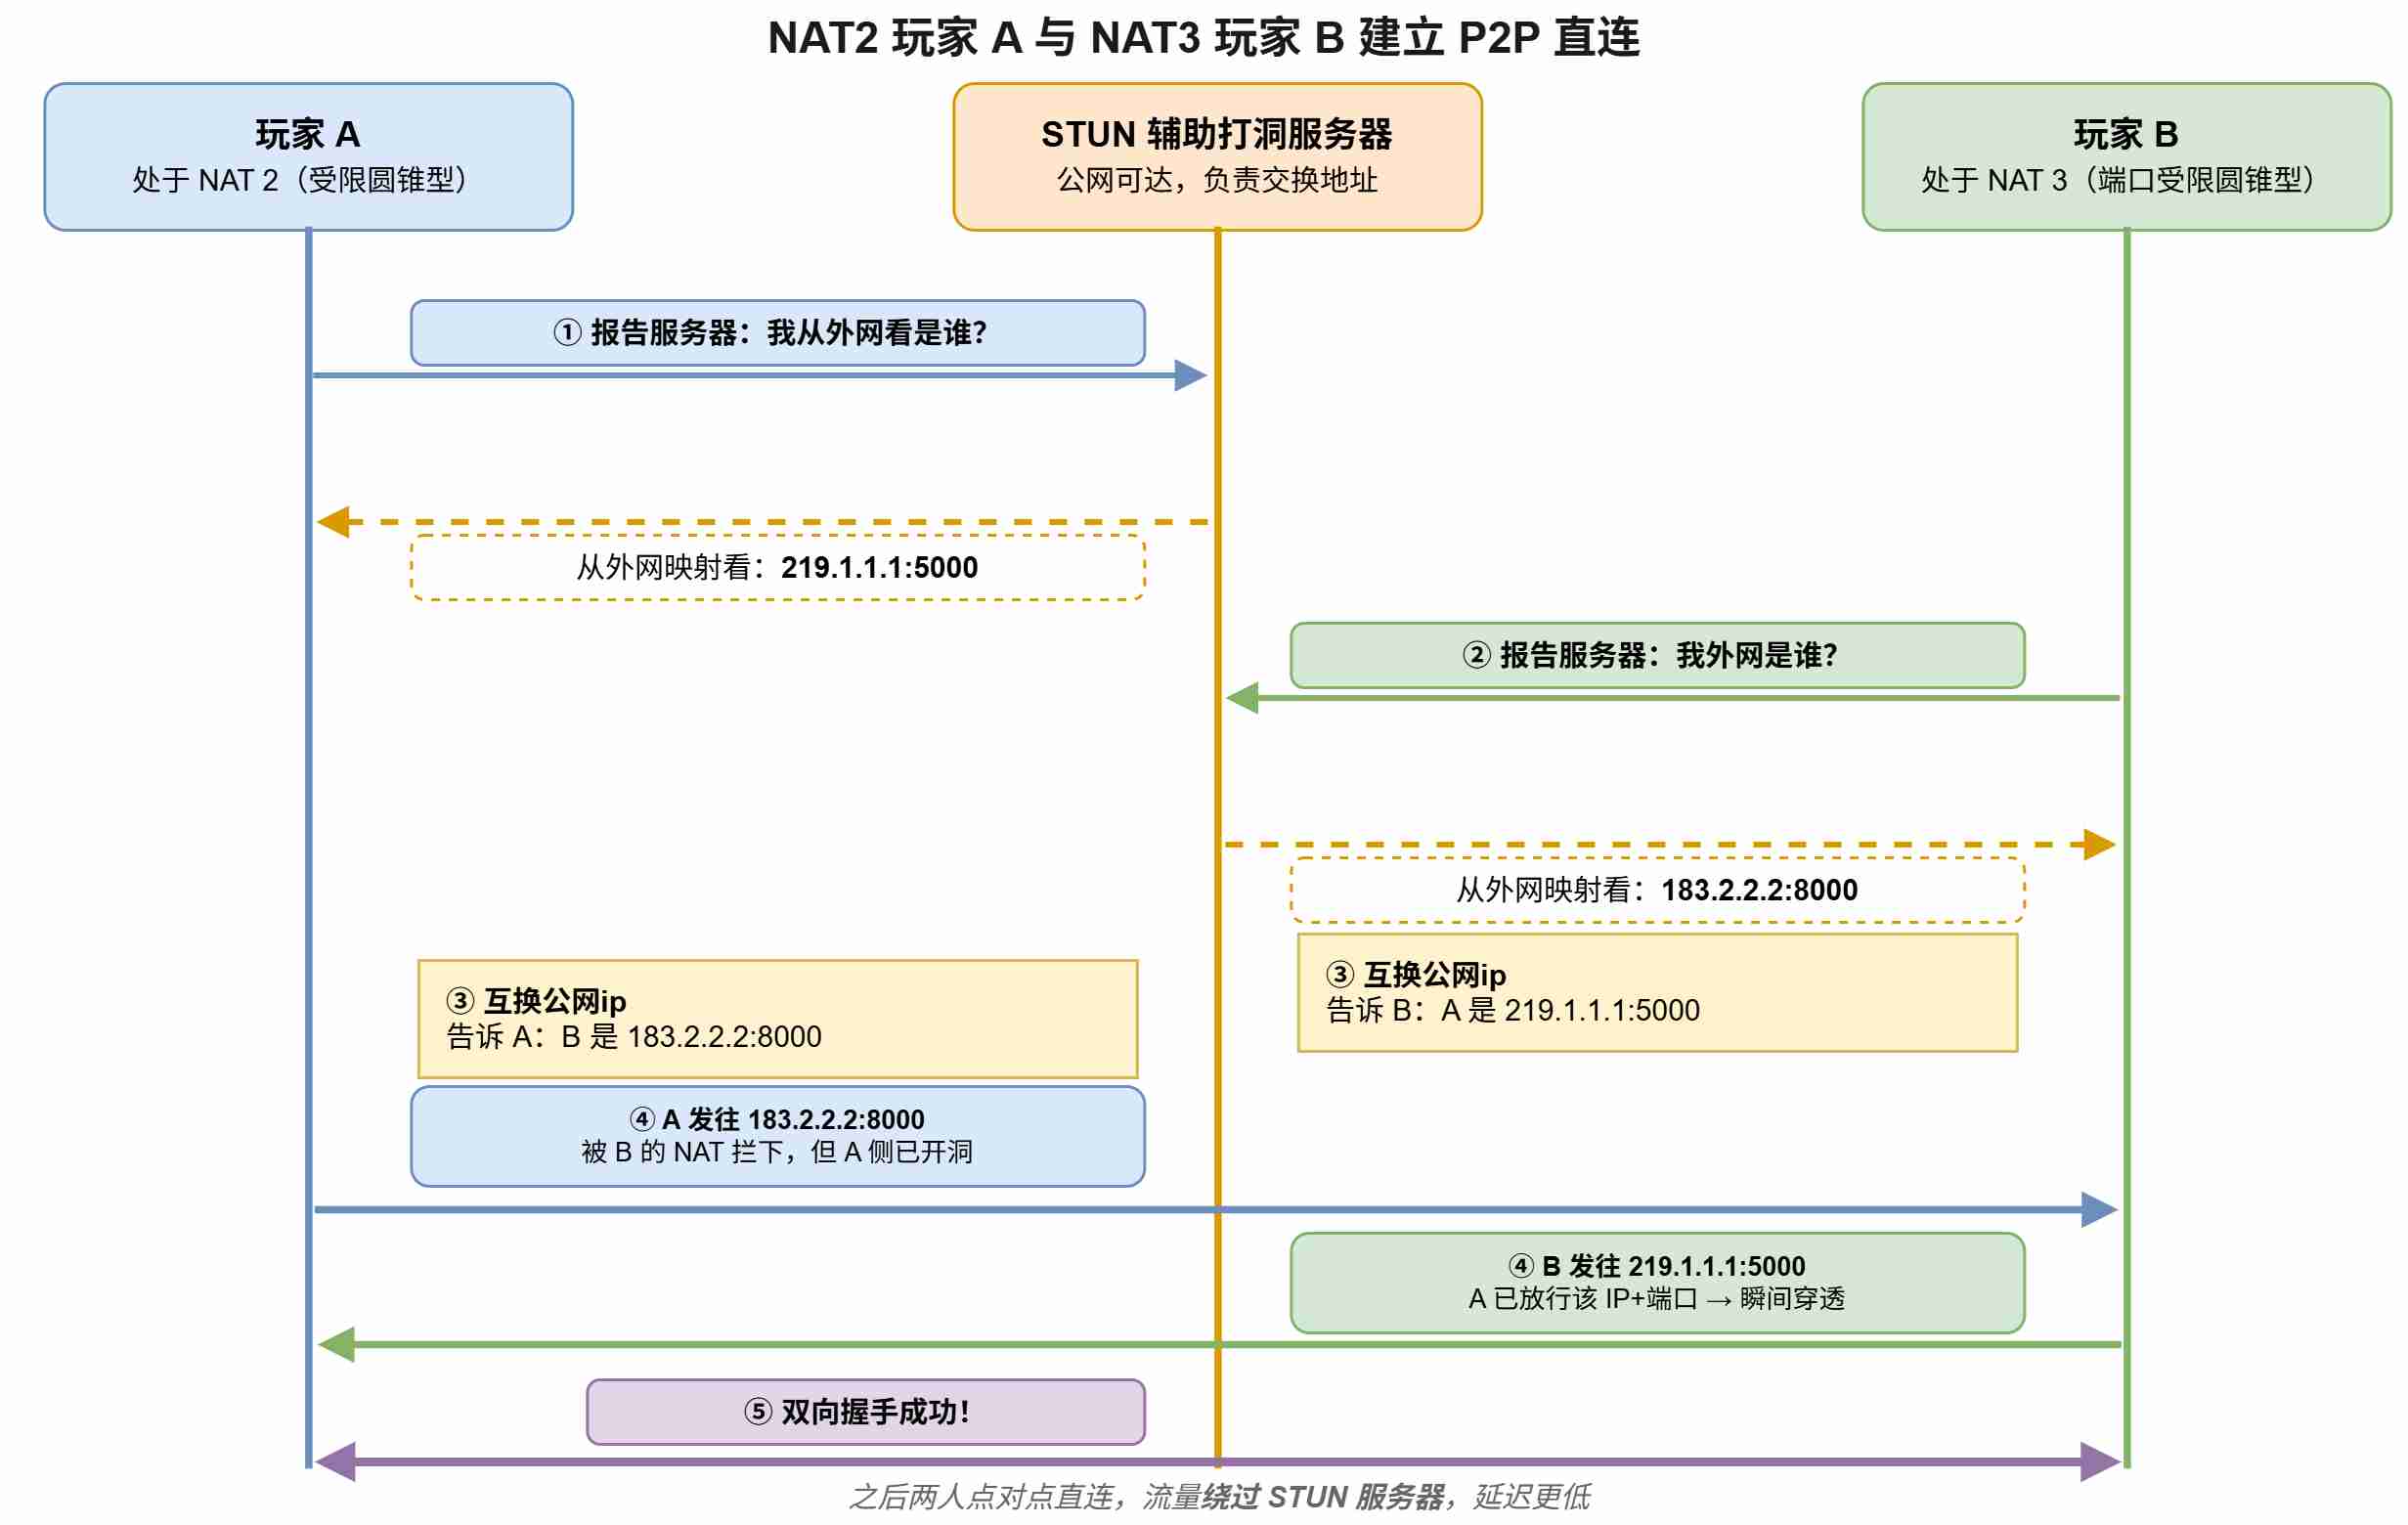
如果检测到一方属于 NAT 4(对称型),或者某些极度恶劣的多层运营商 NAT 拦截,打洞概率将跌破零点。
此时整个架构只能妥协于TURN 协议(Traversal Using Relays around NAT)。
别弄了,认命吧。两人把所有数据全都上传到一台具有独立公网 IP 的中继服务器(Relay Server),由服务器充当传话信鸽。直连的低延迟化为泡影,但是服务器带宽费用成倍飙升,通常只有大企业才有精力和资金这么弄。
4.8 不止一层NAT:CGNAT
你以为只有你家路由器有NAT,但当你兴致勃勃地在自家路由器上配置了端口映射,设置了动态域名解析(DDNS),准备在外网随时连回家里的设备。
结果折腾了三天三夜,外网死活打不开。
你登录进家用路由器的状态页,定睛一看 WAN 口 IP:
我c怎么是100.64.23.105。
恭喜你,已经掉进了运营商级 NAT(Carrier-Grade NAT,简称 CGNAT,RFC 6598)的大坑里。
运营商由于手中的 IPv4 地址极其匮乏,他们不再给每个家庭宽带分配真实的公网 IP,而是在整个小区的上游机房摆放一台巨大的核心路由器,先把所有住户装进专用共享保留段(100.64.0.0/10)。
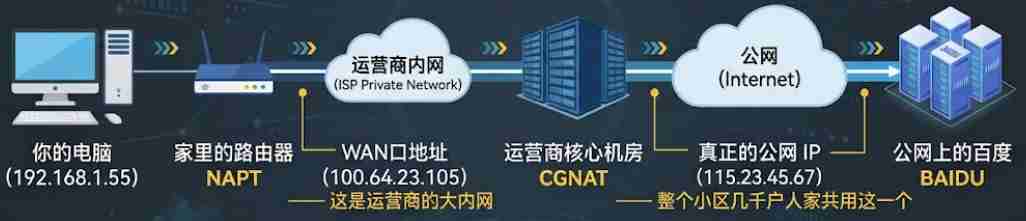
这就是双重 NAT(Double NAT)!
你的家庭路由器只是一个小牢笼,外层还套着运营商的一个超级大牢笼。无论你在自家路由器上怎么摆弄、怎么设端口转发,你都根本触碰不到运营商机房那台 NAT 设备,你的设备沦为只能内网自嗨的孤岛。
想要打破这道死锁,只有四条路:
- 使用人脉;
- 给客服打电话扯皮,成功率低;
- 拥抱 IPv6,借助原生 IPv6 地址直连;
- 使用 FRP基于中继和虚拟组网的内网穿透工具。
4.9 灵魂之问:IPv6 来了,NAT 真的会绝迹吗?
在网络工程师的最初蓝图里,IPv6 普及之日,就是 NAT 进博物馆入土之时。
IPv6 拥有高达 个地址,多到甚至可以为全球每台设备分配一个独立的 /64 子网,彻底复活纯净的“端到端直连”。
但真实世界的演进狠狠打了理想主义者的脸。
即便在全面铺开 IPv6 的今天,NAT 相关的技术思想不但没有死,反而在不断延续:
- 安全与网络拓扑隐藏 很多跨国巨头、金融机构的高管骨子里坚决不接受“把公司每一台 PC 的真实全球单播 IPv6 裸奔暴露在公网上”。哪怕防火墙策略配得再严密,企业依然迷信 NAT 带来的那种“单向玻璃隐身感”。
- 多出口容灾与负载均衡(Multi-homing) 当一家企业同时拉了电信和联通两条千兆光纤时,如果直接用两家分配的原生 IPv6 地址,一旦其中一家断纤,企业内所有连接的全量重连和地址切换成本极其高昂。
因此,工程界妥协搞出了 NPTv6(IPv6-to-IPv6 Network Prefix Translation,RFC 6296),在网络边缘只替换前缀,保留主机位,既享受了地址转换带来的内部拓扑不变性,又避免了改写端口号。
4.10 总结
这一章总结起来,一个数据包跨出家门的完整征途呼之欲出:
局域网侧与路由处理:
目标 IP 越界与帧封装 手机(192.168.1.55)对比子网掩码,判定目标 IP 超出 192.168.1.0/24 范围。发起 ARP 解析获取默认网关 MAC 地址,打包为以太网帧送往路由器。
硬件接收与校验重算 路由器 LAN 口网卡接收数据帧并剥离二层报头。内核核验 IP 首部校验和,将 TTL 递减 1,并重算校验和。
路由表匹配 路由决策引擎匹配 Routing Table,命中
0.0.0.0/0默认路由,决定将数据包送往下一跳网关(光猫 ONT)。Netfilter 连接跟踪与 SNAT 转换 数据包进入 Netfilter 框架,在 conntrack 表中建立五元组映射。将源 IP 从内网地址替换为 WAN 口公网 IP,随机分配空闲源端口,记录映射条目。
出接口封装与物理层发射 重新封装以太网首部,填入光猫 MAC 地址,经 PHY 芯片完成数模转换,通过物理线路发射。
骨干网传输与跨域路由:
核心路由器线速转发 运营商骨干网路由器利用 TCAM 提取 FIB 表信息,结合 OSPF/IS-IS 计算出的最优路径,在硬件层完成二层重封装与线速转发。
自治域(AS)间策略交割 数据包抵达自治域边界,外部网关通过 BGP 协议匹配 AS-PATH 及 Local Preference 等选路策略,完成跨网过境。
逐跳 TTL 递减与介质重封装 传输途中逐跳递减 TTL 值。数据包每经过一台路由器均会重写源/目的 MAC 地址,内层源/目的 IP 保持不变。
目标端响应与反向链路回溯:
入口负载均衡与应用处理 百度集群前置机房接收数据包,检测到的源地址为路由器 WAN 口 IP 及动态端口。七层负载均衡器将请求分发至后端服务,生成响应报文后原路推回。
反向状态检索与 DNAT 还原 路由器 WAN 口收到下行响应包,Conntrack 模块提取五元组查询状态表。命中映射后,将目的 IP 与端口还原为 192.168.1.55 及原始发起端口。
二层投递与网卡接收 路由器重新填入手机 MAC 地址,经 LAN 口交换芯片放入发送队列,通过无线/有线物理介质送达手机网卡缓冲区。